AIを仕事や勉強に活用してみたいけれど、OpenAIのモデルの種類が多すぎて、どこから手をつければいいのか迷っていませんか? ChatGPT、DALL·E、Whisperなど名前は聞き慣れていても、「自分に合ったツール」がどれなのかは意外とわかりにくいものです。この記事では各モデルの特徴と用途をひと目で比較し、あなたの目的にぴったり合った選び方が見つかるようにお手伝いします。
OpenAIのモデルの種類を理解する:主要モデルと技術領域を一覧で確認
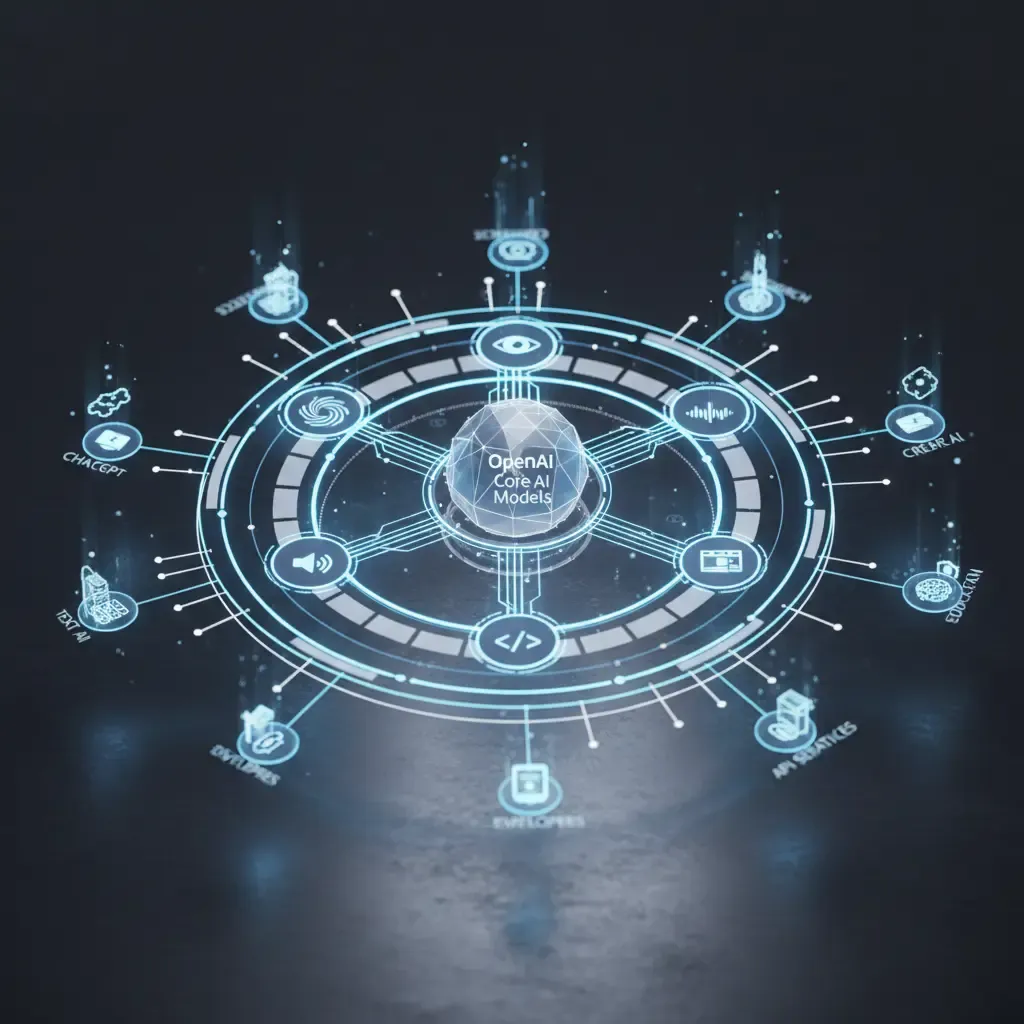
OpenAIのモデルの種類をまとめて理解するには、まずどのような技術範囲をカバーしているのかを見るのが近道です。OpenAIは、テキスト・画像・音声・コード・動画という5つのモダリティにまたがる生成AIのエコシステムを運営しています。そのため、単なる対話型チャットボットにとどまらず、文章生成・画像制作・音声認識・コード作成・動画生成まで、あらゆる領域をひとつのプラットフォームで処理できるのが特徴です。こうした構造があるからこそ「OpenAIモデル10+」と呼ばれるほど細かな機能ラインナップがそろっており、利用目的に合わせて選ぶのがもっとも効率的です。
OpenAIの10を超えるモデルのうち、中核となるのはGPTシリーズ、DALL·E、Whisper、Codex、Soraの5つです。GPTはテキストベースの自然言語処理に特化しており、文章作成・分析・推論といった汎用的な作業を担います。DALL·Eは文章を入力するだけですぐに画像を作ってくれる、ビジュアル生成AIです。Whisperは音声からテキストへの変換に最適化されており、議事録や字幕の作成に強みがあります。Codexは自然言語をコードに変換するモデルで、開発者の生産性を大きく引き上げます。そしてSoraは、テキストの説明だけで実写に近い動画まで生成する次世代の動画AIで、生成AIの領域を動画にまで広げたモデルです。
| モデル名 | 主な機能 | 活用分野 |
|---|---|---|
| GPT | テキスト生成・要約・分析 | 文書作成、学習、自動応答 |
| DALL·E | 画像生成 | デザイン、コンテンツ制作 |
| Whisper | 音声→テキスト変換 | 議事録、字幕制作 |
| Codex | コード自動生成 | 開発支援、自動化 |
| Sora | テキスト→動画生成 | 動画のラフ案、コンテンツ制作 |
OpenAIのモデル全体の地図をつかめたら、次はその中でももっとも中核となるGPT系モデルの細かな違いと活用法を見ていきましょう。
GPT系モデルの種類と特徴の比較
まずGPT-3.5とGPT-4の違いを見ると、もっとも重要なポイントは性能とコスト効率です。GPT-3.5は速度と価格が強みなので、繰り返し作業や簡単な自動応答に向いています。一方のGPT-4は、複雑な問題の解決能力、長文の理解力、クリエイティブな文章の精度が大きく向上しており、リサーチや企画業務では性能の差をはっきり実感できます。とくにGPT-4はハルシネーションの発生率も低く、信頼性の面で優位です。
GPT-4oは、GPT系の中でもとりわけ目を引くマルチモーダルモデルです。テキスト・画像・音声をすべて同時に処理でき、リアルタイムの映像分析まで可能な点が従来のGPT-4との違いです。たとえば画面を映しながら「このグラフの構造はどういう意味ですか?」と尋ねると、すぐに解釈してくれるといった使い方ができます。応答速度も速くコスト効率も良いため、リアルタイムのインタラクションが求められるアプリ開発でも活用度が高いモデルです。
oシリーズ(o3、o3-pro、o4-miniなど)は、GPTシリーズとはまったく性格が異なります。言語表現よりも「推論性能」を中心に設計されたモデルなので、数学・科学の問題、データ分析、複雑な論理検証といった高度な作業で力を発揮します。o3-proはとくに生成AIの性能ベンチマークでも上位に位置しており、研究や専門文書など正確性が重視される環境で好まれています。反対に、軽い回答やクリエイティブな文章作成だけが目的なら性能過剰となり、かえって非効率になることもあります。
無料と有料での利用範囲の違いもはっきりしています。無料ユーザーが使えるのはGPT-4.1-miniのみで、速度は速いものの品質には限りがあります。PlusユーザーからはGPT-4oまで利用でき、マルチモーダル機能を自由に活用できます。Proプランではo3-proまで使えるため、高度な推論作業が可能になります。
| モデル名 | 主な機能 | おすすめの利用シーン |
|---|---|---|
| GPT-3.5 | 高速な応答・コスト効率 | チャットボット、繰り返しの質問対応 |
| GPT-4 | 正確性・推論・クリエイティブな文章作成 | リサーチ、レポート作成 |
| GPT-4o | テキスト・画像・音声のマルチモーダル | リアルタイム分析、アプリ開発 |
| GPT-4.1 | 長文の一貫性・指示への忠実度の向上 | 企画、文書の自動化 |
| o3 | 高度な推論・数学・コーディング | 問題解決、技術分析 |
| o3-pro | 専門的な分析・精密な作業 | データ分析、研究文書 |
言語中心のGPTモデルを見てきたところで、次はビジュアル面の創造性とデザインを担う画像生成モデル、DALL·Eを詳しく見ていきましょう。
DALL·E 画像生成モデルと活用事例
DALL·Eはテキストを入力するだけですぐにビジュアル素材を作れるため、製品のラフ案やマーケティング用の画像を急いで用意したいときにとくに役立ちます。DALL·E 3はGPT‑4をベースにしていてプロンプトの理解度が高く、「青空の下の未来都市の絵」のような短い文章を入れるだけでも細部まで反映した自然な画像を生成します。ChatGPTの画面内でそのまま作れるので別のツールを立ち上げる必要もなく、解像度や質感の表現も以前のバージョンより格段に安定しています。そのため、ラフ案の制作、ブランドイラスト、コンテンツ用ビジュアルなど、速くて直感的なアウトプットが求められる作業で活用度が高いモデルです。
DALL·Eの使い方はシンプルです。プロンプトに希望するスタイル・構図・雰囲気を書くだけでよく、必要に応じて「広告用の商品カットのようなリアルな雰囲気で」と明示すれば、出力の方向性を調整できます。画像生成AIの比較という観点では、DALL·Eはプロンプトの解釈力と自然な仕上がりに強みがある一方、Stable Diffusionのような完全なカスタマイズには比較的制約があります。以下は主なモデルの比較です。
- DALL·E
- Stable Diffusion
- Midjourney
- Runway
| AIの名前 | 特徴 | 用途 |
|---|---|---|
| DALL·E | プロンプトの理解度が高い | ラフ案・マーケティング画像 |
| Stable Diffusion | ローカルでのカスタマイズ | 特殊なスタイルの研究 |
| Midjourney | 芸術的なスタイルに強い | アートワーク制作 |
| Runway | 動画・画像の統合編集 | 動画ベースのビジュアル作業 |
画像ができあがったら、次は聴覚の領域へ移り、WhisperとTTSがどのように音声を認識・生成するのかを見ていきましょう。
WhisperとTTS:OpenAIの音声モデルの種類
Whisper音声認識モデルは、音声をそのままテキストに変換するSTTベースのモデルなので、実務で必要なときにすぐ活用しやすいのが特長です。さまざまな言語やアクセントを安定して処理でき、ある程度の雑音環境にも対応するため、議事録の自動化や動画の字幕制作といったリアルタイム業務に強みがあります。とくに平均エラー率が低く修正の手間が少ない点は、数あるツールの中からWhisperが選ばれる理由としてよく挙げられます。多言語の会議やインタビューなど、テキスト変換の正確性が重要なプロジェクトに適しています。
TTSはテキストを自然な音声に変換するAI音声合成モデルの一種で、プレゼン用のナレーションやチャットボットの音声応答など、音声で情報を伝える場面で効果を発揮します。一部のバージョンでは15秒程度の短いサンプルがあれば特定の人物の声のトーンを反映して合成できますが、保護上の課題があるため公開形態は限定的です。Whisperが「聞いて書き取る」役割なら、TTSは「話してくれる」モデルであり、方向性がまったく異なります。
WhisperとTTSをあわせて考えると、音声変換・認識モデルの比較がずっとわかりやすくなります。WhisperはSTT中心なので記録・文書化・検索可能なデータの蓄積に向いており、TTSは伝わりやすさを高める方向に特化しているため、カスタマーセンターの自動音声応答や多言語の案内音声制作によく使われています。実際の生成AIの活用事例を見ても、会議の文字起こし自動化→Whisper、プレゼンテーションの吹き替え→TTSのように、利用シーンが分かれる傾向があります。
| モデル名 | 主な機能 | 代表的な活用分野 |
|---|---|---|
| Whisper | 音声→テキスト変換(STT) | 議事録作成、字幕制作 |
| TTS | テキスト→音声合成 | ナレーション、自動音声応答 |
OpenAIには言語・音声モデルのほかに、コーディング専用のモデルCodexもあります。次は、コード作成に特化したOpenAIのモデルを見ていきましょう。
Codex コーディング支援モデルの役割と開発での活用
Codexは自然言語をそのままコードに変換してくれる開発特化型のエンジンで、繰り返しの関数作成やスクリプトの下書き生成といった作業をもっとも素早く減らしてくれます。Pythonを含む10以上の言語に対応し、自動補完・エラー修正・コメント生成までまとめて処理できるため、コーディングAIの性能ランキングでも常に上位に名前が挙がるモデルです。開発者向けチュートリアルに沿って進めれば、基本的なCRUDテンプレートの生成はもちろん、「このロジックを最適化してください」といった自然言語の指示もそのままコードパターンに変換され、実務の自動化に大いに役立ちます。
CodexはGitHub Copilotの中核エンジンとして、すでに開発者が日々使うワークフローに自然に溶け込んでいます。たとえば繰り返しコードの自動生成、関数の雛形の自動補完、構文エラーのデバッグといった作業をCopilotがリアルタイムで提案しますが、このプロセスはすべてCodexをベースにしています。必要であればOpenAI SDKやライブラリを通じて自社のAPIサーバーにカスタムのコーディング支援ツールを組み込めるため、チーム単位で社内専用のコードジェネレーターを構築することも可能です。
- 自然言語→コード変換
- コードの自動補完
- エラーのデバッグ支援
- コメントの自動生成
- プロジェクトごとのカスタマイズAPI
こうした個々のモデルが統合されると、OpenAIのエコシステム全体がどのように機能しているのかを理解する必要が出てきます。次は、OpenAI APIとその実際の運用方法を見ていきましょう。
OpenAI APIとサービス統合の仕組み
OpenAI APIは、GPT、DALL·E、Whisper、CodexといったOpenAIの各種モデルを外部のアプリやサービスに直接つなぐためのインターフェースで、ひとつのエンドポイントからさまざまなモダリティを呼び出せる構造になっています。ポイントは、すべてのリクエストがトークンベースの使用量で計算されることです。モデルごとに処理単価や入力・出力トークンのルールが異なるため、初期の設計段階でコストの流れを先に押さえておくことが重要です。とくにGPT‑4oやo3のような高性能モデルは、マルチモーダル処理が入るとトークン消費が速くなるため、プロンプトの最小化やキャッシュ戦略をあわせて検討することが実務の効率を大きく左右します。APIのセキュリティも重要で、APIキーは決してクライアント側に直接露出させず、サーバーの環境変数に分けて管理するのが基本です。
OpenAI APIの使い方は、構造そのものはシンプルです。APIキーはアカウントの設定メニューから新しいキーを作成して発行し、それをサーバーコードの環境変数に設定したうえで、RESTまたはSDKで呼び出すだけです。API利用料の支払いも使用量ベースの課金体系なので特別に複雑な手続きはなく、月ごとの請求書が自動で作成される形です。リクエストを設計する際はトークン管理の戦略が実務の要となるため、プロンプトを再利用したり、systemメッセージを共通テンプレートにまとめたりする方法が料金の最適化に効果的です。OpenAIモデルのカスタマイズは、基本的にファインチューニングや指示の最適化によって行います。チャットボット・分類モデル・文書自動化システムのように目的が決まっている場合は、構造化したプロンプトとベクトルストアを組み合わせることで安定性が高まります。
サービス統合の段階では、各モデルの特性に合わせたルーティング設計が重要です。たとえばカスタマーサポートのチャットボットはテキスト中心なのでGPT‑4.1やGPT‑4oを基本とし、画像や添付ファイルの分析が必要な場合はリクエストを自動で振り分けてDALL·EやWhisperに渡す構成が安定します。プロンプトチェーンの自動化もAPIベースで簡単に実装でき、ログ分析、レポートの自動生成、マルチモーダルな相談システムの構築など、さまざまなワークフローが実現できます。以下の表は、モデル別の代表的な料金区分の例です。
| 料金区分 | モデル | 主な用途 |
|---|---|---|
| テキスト中心 | GPT‑4o / GPT‑4.1 | チャットボット、文書の自動化 |
| 画像生成 | DALL·E | ラフ案、ビジュアル制作 |
| 音声認識 | Whisper | 議事録、字幕変換 |
| コード生成 | Codex | スクリプトの自動生成・補完 |
最後に、ここまで見てきたOpenAIのモデルを実際の目的別に比較・選択できるよう、用途別のおすすめガイドをまとめます。
目的別・OpenAIのモデルの選び方ガイド
もっとも重要な基準は「何をしたいのか」です。同じOpenAIのモデルでも、目的によって性能に対する効率が大きく変わるため、まず作業の種類を決めてからモデルを選ぶのがもっとも実用的です。以下の項目は、実際の業務や学習の場面でよく尋ねられる用途を基準にまとめました。
- 文書作成
- デザイン・画像制作
- コーディング・自動化
- 音声処理(STT/TTS)
- 動画生成
- データ分析・高度な推論
- 学習・教育のサポート
| 目的 | おすすめモデル | 理由 |
|---|---|---|
| 文書作成 | GPT‑4 / GPT‑4.1 | 長文の一貫性・正確性・クリエイティブな表現が安定 |
| デザイン・画像制作 | DALL·E 3 | プロンプトの解釈力が高く、ラフ案の制作が速い |
| コーディング・自動化 | Codex | 自然言語→コード変換が正確で、エラー修正にも対応 |
| 音声処理 | Whisper / TTS | WhisperはSTTの精度が高く、TTSは自然な音声を生成 |
| 動画生成 | Sora | テキスト→実写風の動画生成が可能 |
| データ分析・高度な推論 | o3 / o3-pro | 数学・論理・分析の性能がトップクラス |
| 学習・教育のサポート | GPT‑3.5 / GPT‑4.1-mini | 無料で手軽に使え、繰り返しの説明に強い |
無料か有料かを選ぶ基準はシンプルです。繰り返しの質問・基礎的な学習・簡単な作業ならGPT‑3.5やGPT‑4.1-miniで十分で、画像・マルチモーダル・高度な推論が必要なら有料プランでGPT‑4oやo3-proを選ぶほうがはるかに効率的です。勉強用のおすすめAIを選ぶならコストに対する活用度が大切なので、テキスト中心であればGPT‑4.1-miniから始め、デザイン・コーディング・音声の作業が入った段階で専用モデルを併用するのがおすすめです。業務中心であれば、トークンコストがかかっても正確性の高いGPT‑4やo3系のほうが、時間を大幅に節約してくれます。
OpenAIのモデルを種類別に比較して、自分に合ったAIを選ぶ
冒頭で感じた戸惑いのとおり、OpenAIにはさまざまな種類のモデルがありますが、各モデルの役割と特徴を区別できれば、自分に合ったツールを見つけるのは意外と簡単です。ChatGPTは対話と文章作成が中心の言語モデル、DALL·Eは画像生成特化型、Whisperは音声認識のエキスパートと理解すれば、方向性がはっきりします。また、GPT-4やoシリーズのような最新バージョンはマルチモーダル機能や推論能力に強みがあるので、活用目的に応じて選択肢を絞り込むとよいでしょう。
結局のところ、OpenAIのモデルの種類を理解するカギは「自分がどんな課題を解決したいのか」にあります。簡単な回答の生成から画像コンテンツの制作、音声のテキスト変換まで、目的に応じてモデルを分類すれば、情報の複雑さよりも効率的な活用戦略が見えてくるはずです。こうして各ツールの役割を明確に整理することで、OpenAIの幅広い機能の中から、自分のニーズに合ったものを自信を持って選べるようになるでしょう。
最初の混乱が整理できた今、ご自身の学習や業務の環境でどのモデルがもっとも効率を高めてくれるのか、ぜひ実際に試してみてください。