Pythonにはある程度慣れているのに、いざ欲しいWebデータを集めようとすると、どこから手をつければいいのか途方に暮れたことはありませんか?サイトごとに構造が違い、コードは複雑に見え、さらに法的な問題まで気になるなら、この記事はきっとお役に立てるはずです。
クローリングとWebスクレイピングの違いを正しく理解する
クローリングとは、Web上の情報を自動で巡回しながらデータを収集する技術です。
簡単に言うと、クローラー(bot)が開始URLから出発し、リンクをたどってさまざまなサイトを巡りながらHTMLデータを取得していく仕組みです。
この過程で、ページ構造や内部リンク、データ全体の文脈などを把握できます。
たとえば求人情報を自動で集めるサービスでは、複数の企業の採用ページをすべて訪問して情報を集める必要があります。
こうした場合にはWebクローリングが効果的です。
つまり、どこにどんな情報があるのかを整理することが主な目的です。
全体構造の把握に強いからです。
一方、Webスクレイピングはこれと少し異なります。
すでに対象として定めた特定のWebページから、決められた情報だけを「ピンポイントで」抜き出す方法です。
たとえば「A社の商品詳細ページ」から商品名、価格、レビュー数といった項目だけを抽出するのがスクレイピングです。
つまり、クローリングが「情報を探すために図書館全体を歩き回ること」だとすれば、スクレイピングは「図書館から特定の本を1冊取り出し、必要な文章だけを抜き書きすること」と考えるとわかりやすいでしょう。
両者の主な違いを、次の表にまとめます。
| 区分 | Webクローリング | Webスクレイピング |
|---|---|---|
| 定義 | Webページのリンクを自動でたどりながら大量に巡回 | 特定のWebページから必要なデータだけを抽出 |
| 作業方法 | リンクをたどって移動しながら全体構造を収集 | 指定した要素からテキストや値を抽出 |
| 目的 | 大量のWebデータの取得とインデックス化 | 特定の情報を整理・活用するための収集 |
| たとえるなら | 探索者(Explorer) | 精密収集者(Sniper) |
Webクローリングの仕組み:どのようにデータを収集するのか?
Webクローリングとは、インターネット上を自動で巡回し、必要な情報を取得するプロセスのことです。
この作業はクローラーまたはスパイダーと呼ばれるプログラムが行い、検索エンジンやニュース収集システム、ECサイトの価格比較サービスなどで幅広く活用されています。
では、このクローラーはいったいどのような仕組みで動いているのでしょうか?
簡単に言えば、あるWebサイトのURLを出発点として、その中のリンクを次々にたどりながらHTML情報を収集する構造です。
この過程はすべて自動で繰り返されるため、大量のデータをすばやく取得できます。
Webサイトの構造分析が重要な理由もここにあります。
ページごとにHTMLの構成やリンクの張り方が異なるため、それを把握してはじめて正確なデータ収集が可能になるのです。
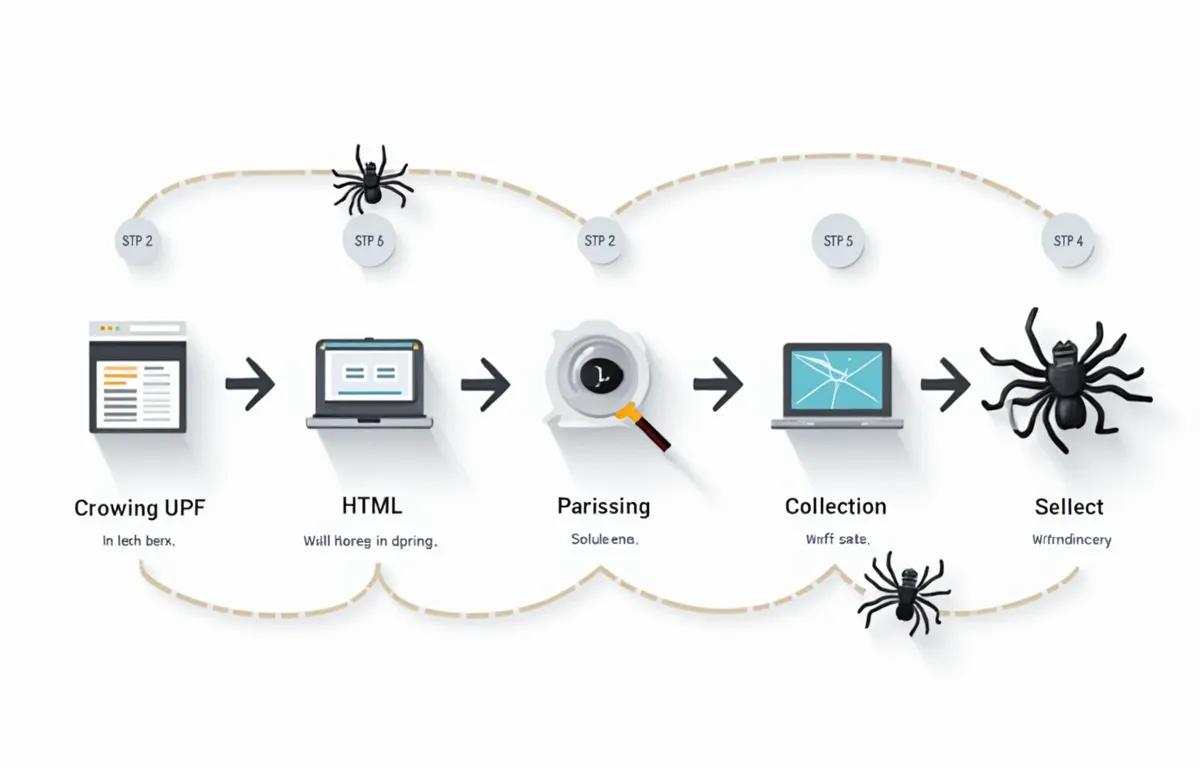
実際のクローリングは、次の5つのステップで行われます。
-
ステップ1:開始URLの設定
クロールするWebページのアドレスを決めます。例:https://example.com -
ステップ2:Webページのリクエスト
プログラムがURLにアクセスしてHTMLドキュメントを取得します。 -
ステップ3:HTMLのパース
取得した内容を構造化された形で解析します。タグやクラス名などを分析し、必要な情報がどこにあるかを探す工程です。 -
ステップ4:データの抽出と保存
テキスト、画像、価格など、目的のデータを抜き出して保存します。 -
ステップ5:新しいリンクの探索と繰り返し実行
現在のページ内にある別のリンクを見つけてそのページへ移動し、上記の工程を繰り返します。
クローリングは初心者には馴染みがなく複雑に感じられるかもしれませんが、このようにステップごとに流れを理解すれば、ぐっと取り組みやすくなります。
データ収集を体系的に自動化するうえで最も基本となる概念なので、ぜひ押さえてから始めましょう。
Pythonで始めるWebクローリング:BeautifulSoup実践
Pythonを使ってWebからデータを取得する最もシンプルな方法の一つが、BeautifulSoupを活用したクローリングです。
初心者でも無理なく真似できるほど構造が直感的で、必要なデータにだけピンポイントでアクセスできるため、入門用に最適です。
最初にやることは、requests ライブラリで情報を取得したいWebページにアクセスすることです。
その後、BeautifulSoup を使ってHTML構造をパースし、目的の要素を指定して出力できます。
以下は、商品一覧ページから商品名を抽出するごく基本的な例です。
import requests
from bs4 import BeautifulSoup

# ステップ1: Webページのリクエスト
url = "https://example.com/products"
response = requests.get(url)

# ステップ2: HTMLのパース
soup = BeautifulSoup(response.text, "html.parser")

# ステップ3: 特定のタグを抽出(例:商品名が入った h2 タグ)
product_names = soup.find_all("h2", class_="product-title")
for name in product_names:
    print(name.get_text().strip())
上のコードは、3つの重要な工程を忘れないよう分けて構成しています。
- 最初に
requests.get()でHTMLページを取得する - 次に
BeautifulSoup()でHTMLをパースする - 最後に
.find_all()関数を使って特定のタグの情報を抜き出す
クローリングは結局「いかに簡単に欲しい情報を絞り込めるか」の勝負なので、この基本構造さえしっかり覚えておけば、ほとんどのWebサイトに応用できます。
主な関数のまとめ
| 関数 | 説明 | 例 |
|---|---|---|
| requests.get() | WebサーバーにHTTP GETリクエストを送り、HTMLを返す | requests.get(“https://example.com”) |
| BeautifulSoup() | HTMLドキュメントをパースし、アクセス可能なオブジェクトに変換 | BeautifulSoup(html, “html.parser”) |
| find_all() | 一致するすべてのタグをリストで返す | soup.find_all(“h2”) |
動的WebページとSeleniumを活用した高度なWebクローリング
静的なHTMLのWebページなら、BeautifulSoupだけでも十分にデータを抽出できます。
しかし現代の多くのWebサイトでは、ユーザーの操作に応じてコンテンツが動的に生成されます。こうした動的Webページの処理には、BeautifulSoupでは限界があります。
そこで力を発揮するのがSeleniumです。
Seleniumは、ユーザーのように実際のブラウザを自動で操作するツールです。
JavaScriptが実行されてはじめて表示されるデータも扱えるのが、最大の特徴です。
たとえば無限スクロール、クリックで開くレビュー欄、フィルター適用後の結果ページにも対応できます。
Seleniumの使い方は難しく感じるかもしれませんが、次の例を見ればすぐに流れをつかめるはずです。
from selenium import webdriver
from selenium.webdriver.common.by import By
import time

# ステップ1: ブラウザを開く
driver = webdriver.Chrome()

# ステップ2: 動的ページへ移動
driver.get("https://example.com/comments")
time.sleep(3)  # JSのレンダリングを待機

# ステップ3: ボタンをクリック(例:「もっと見る」)
load_more = driver.find_element(By.CLASS_NAME, "load-more-btn")
load_more.click()
time.sleep(2)

# ステップ4: コメントのテキストを収集
comments = driver.find_elements(By.CLASS_NAME, "comment-text")
for c in comments:
    print(c.text)

driver.quit()
単にページにアクセスしてデータを取得して終わりではなく、ボタンをクリックしたりスクロールしたりと、実際に「操作」する方式こそがSeleniumの核心です。
そのため、クローリング用ライブラリの中でも特別なポジションを占めています。
Seleniumの主な機能まとめ
- 実際のブラウザでレンダリングしたうえでデータを収集できる
- JavaScriptで生成されたコンテンツにも完全に対応
- ボタンのクリックやフォーム入力などの操作を自動化できる
- 無限スクロールやAJAXによる変化にも対応できる
ただし注意点もあります。
リクエストが速すぎるとブロックされることがあり、レンダリング時間を考慮せずにすぐ抽出すると、空の結果が返ってくることもあります。
sleep() や WebDriverWait などを使うのを忘れないでください。
動的Webページの処理では安定性が鍵です。
Webクローリングツールの比較:GUIベース vs コードベース
クローリングを始めるには、まず自分に合ったツールを選ぶ必要があります。
大きく分けるとGUIベースのツールとコードベースのライブラリがあり、それぞれに明確な長所と短所があります。
コーディングを知らなくても手軽に使える無料のクローリングツールとしては、Octoparse、ParseHub、そしてSEO分析用として有名なScreaming Frogがあります。
このうちScreaming Frogは、GUIツールの中でも特にWebサイトの構造分析や内部リンクのクロールに非常に強いのが特長です。
ボタンをクリックするだけで、特定のURLから画像、メタデータ、重複コンテンツまできれいに収集できるので、非エンジニアやマーケターでも使いやすいツールです。
一方、プログラミングに慣れている方なら、コードベースのツールのほうが強力で柔軟です。
代表的なオープンソースのWebクローラーとしてはScrapyが挙げられます。
これにBeautifulSoupとSeleniumを組み合わせれば、静的ページから動的ページまで問わず、欲しいデータを抽出できます。
特にSeleniumは、JavaScriptのレンダリングが必要なサイトで非常に役立ちます。
ただしある程度のコーディング知識が必要なので、ハードルはやや高めです。
主なツールを次の表で比較してみましょう。
| ツール名 | タイプ | 特徴 | おすすめの対象 |
|---|---|---|---|
| Screaming Frog | GUI | SEO最適化と構造分析に特化 | マーケター、初心者 |
| Octoparse | GUI | ドラッグ&ドロップ方式、ログインにも対応可能 | 非エンジニア、リサーチャー |
| ParseHub | GUI | 複雑なHTMLも視覚的に設定可能 | 初心者ユーザー |
| BeautifulSoup | コードベース | HTMLのパースが最もシンプルで直感的 | 開発の入門者、実習用 |
| Scrapy | コードベース(オープンソース) | 拡張性が高く高速、大量データに適している | 開発者、データエンジニア |
クローリングで必ず知っておくべき法的問題と倫理ガイド
Webからデータを自動で収集する際、まず確認すべきなのは、その行為が合法かどうかです。
「クローリングは違法ですか?」という質問に対する最も正確な答えは、場合によっては違法になり得るです。
クローリングそのものは技術的に中立ですが、無秩序に行えば法的責任を問われる可能性があります。
特に次の3つのクローリングの違法性に関わる問題は必ず押さえておきましょう。
-
robots.txt ファイルへの違反
ほとんどのWebサイトには「robots.txt」ファイルがあり、クローラーのアクセスを許可するパスとブロックするパスが明記されています。これを無視してコンテンツを取得すると、「意図的なアクセス制限の回避」とみなされる可能性があります。 -
Webサイトの利用規約の無視
多くのサイトは規約で「自動化ツールの使用禁止」を明記しています。これに違反すると、民事訴訟のリスクが生じます。 -
サーバーへの過剰なリクエスト送信
極端に短い間隔で大量のリクエストを送ると、相手のサーバーが過負荷になることもあります。これは単なるマナー違反にとどまらず、DDoS攻撃と解釈されるおそれもあります。
とはいえ、クローリングが可能なサイトも存在します。
たとえば、公開データセットを提供していたり、APIの利用について明確なガイドラインやレート制限(Rate Limit)などを示していたりする公共機関やオープンプラットフォームは、安全にデータを抽出できる場所です。
クローリングは一般的に、ニュース、商品情報、ソーシャルメディアなどから必要な情報を自動で抽出するために使われる技術ですが、これを合法的に活用するには、次のチェックリストを基準にするとよいでしょう。
安全なWebデータ抽出のためのチェックリスト
-
1. robots.txt の確認は必須
クローラーのアクセス可否と範囲を robots.txt で事前に確認 -
2. 利用規約の把握と遵守
自動化ツールの禁止条項がないかをしっかり読む -
3. リクエスト速度の制限
time.sleep()やレート制限(Rate Limiting)でサーバー負荷を防ぐ -
4. 個人情報が含まれていないかの確認
氏名やメールアドレスなど、機微な情報を含むコンテンツは収集対象から除外 -
5. 出典と著作権表示の検討
データを再利用する際は出典を明記し、ライセンス条件を確認
最終的に重要なのは、「できるかどうか」よりも「許可されているかどうか」です。
技術的に収集できるからといって、何をしてもよいというわけではありません。
データ収集のプロセス全体を通じて、法的・倫理的リスクを最小限に抑える戦略を常に意識しておく必要があります。
クローリング自動化のための高度な戦略とパフォーマンス最適化のコツ
大量のデータを定期的に収集しなければならない状況では、単純なコードを繰り返し実行するだけでは到底足りません。
そんなときに欠かせないのが、クローリングの自動化とクローリングの最適化の戦略です。
収集速度、成功率、サーバーの安定性を同時に確保することが鍵です。
たとえば、数万件のURLにアクセスしなければならないと仮定してみましょう。
単純に requests.get で1件ずつアクセスすると、サーバーにブロックされたりタイムアウトが発生したりして、作業全体に何日もかかることもあります。
しかし、いくつかの設定をきちんと行えば、リアルタイムのデータ収集に近いレベルまで速度を引き上げることができます。
これから紹介する6つのコツは、実際の現場ですでに広く使われている方法です。
クローリングの自動化システムを組む際は、ぜひ一度ずつチェックしてみてください。
クローリングの自動化と最適化のための6つのコツ
-
1. リクエスト間の待機時間を設定(time.sleep)
一定の速度でリクエストを調整すれば、サーバーによるブロックを避けられます。とにかく速くよりも「持続可能な速度」が重要です。 -
2. ユーザーエージェント(User-Agent)の変更
ブラウザを装うヘッダー設定は基本です。サイトごとにフィルタリングの基準があるため、さまざまなUAをローテーションさせると効果的です。 -
3. IPの分散(プロキシ or Tor)
1つのIPにリクエストが集中しすぎると、すぐにブロックされます。複数のIPプールやTorネットワークを活用して、リクエストを分散させましょう。 -
4. 重複URLの除外&キャッシュの活用
すでにアクセスしたURLを除外したりキャッシュしたりして不要な再アクセスを防げば、ずっと効率的になります。 -
5. エラーハンドリングの仕組みを確立(try-except + ログ記録)
失敗時のリトライ処理やログ情報の保存がなければ、集めたデータの信頼性は下がらざるを得ません。 -
6. 非同期処理(asyncio)またはマルチスレッド(threading)
複数のリクエストを並列処理すれば、体感速度がぐっと上がります。Pythonの標準モジュールで十分に実装できます。
クローリングの自動化をうまく設計すれば、単に時間を節約できるだけでなく、リアルタイムのデータ収集のように、トレンドの変化や競合の動向まで機敏に取り込めます。
反応速度が重要な今のような環境では、選択肢ではなく必須といえます。
さまざまなクローリング事例:ニュース、ECサイト、YouTubeまで
クローリングは、どのデータを収集するかによって、アプローチや使うツールが大きく変わります。
ニュース記事、ECサイトの価格、YouTubeのコメントのように需要の高いデータは、それぞれの特性に合った方法で処理してこそ最適な結果が得られます。
代表的な3つの事例を見ながら、それぞれのクローリングがどのように行われるのかを見ていきましょう。
1. ニュースデータのクローリング:RSSベースの自動収集
ニュースは刻々と更新されるため、リアルタイムの収集と効率性が鍵です。
最も安全で性能も良い方法は、GoogleニュースのRSSフィードを活用する方法です。
ここでは feedparser ライブラリを使って、最大100件の最新ニュースを一度に取得できます。
記事のタイトル、リンク、日付といったメタ情報をすばやくパースできるうえ、HTMLも最小限なので、データのクレンジングも簡単です。
さらにRSSフィードはブラウザ操作なしでも動作するため、セキュリティ面でも安心で、速度も一般的なSeleniumベースより2〜3倍速くなります。
大手メディアのニュースにはほとんどRSSのアドレスが用意されているため、適用範囲も広いです。
2. ECサイトの価格収集:定期クローリングで価格変動を追跡
ECサイトは商品ページの構造が比較的明確な一方で、価格は頻繁に変わります。
そのため、1回きりではなく「定期的に」繰り返しクローリングすることが鍵です。
たとえば、特定のデジタルカメラの価格を毎日決まった時間にチェックし、グラフで推移を描くといった方法です。
こうした場合には requests と BeautifulSoup の組み合わせが最もよく使われます。
韓国のECサイトであるCoupang(クーパン)や11番街(11st)のようなサイトでは動的コンテンツが一部混在していることもあるため、必要に応じてSeleniumでレンダリングしてからデータを抽出する方法も併用します。
主に取得する情報は商品名、価格、レビュー数などで、繰り返し実行するために cron やスケジューラーと連携させるシステム構成がよく使われます。
3. YouTubeコメントの収集:APIとSeleniumの併用
YouTubeの場合、コメント欄は動的にレンダリングされ、ユーザーの操作に応じて表示されるため、単純な requests では対応が難しいです。
解決方法は2つあります。
-
1つ目はYouTube Data APIを活用する方法で、公式APIを通じてコメントのテキストやメタ情報を構造化された形で受け取れます。ただしクォータ制限があるため、大量収集には不向きです。
-
2つ目はSeleniumでページを直接開き、スクロールしながらコメントを収集する方法です。
この方法では画面上に表示されるすべてのテキストにアクセスできますが、速度や性能の面では重くなります。
どちらのツールを使うかは目的と範囲によって変わります。分析用のサンプルならAPI、一度きりの大量抽出ならSeleniumのほうが有利です。
代表的な事例のまとめ
| 事例 | ツール | 技術 | 特徴 |
|---|---|---|---|
| ニュースデータのクローリング | feedparser | RSSデータのパース | 高速でセキュリティ面も安心 |
| ECサイトの価格収集 | BeautifulSoup / Selenium | 定期リクエスト + HTMLパース | 価格推移の分析が可能 |
| YouTubeコメントの収集 | YouTube Data API / Selenium | REST API or 動的レンダリング処理 | 構造化・非構造化データの両方に対応可能 |
Webクローリングの実践に役立つおすすめ資料と学習ステップ
クローリングをマスターするには、単にコードを書き写すだけでなく、実際のデータを中心とした実習が重要です。
なかでも書籍、サンプルコード、クローリングツールの活用などを組み合わせて取り組むと、理解度と応用力がぐっと高まります。
実践重視の学習として入門者におすすめの本に、韓国語の書籍『이게 되네? 챗GPT 미친 크롤링 24제』(直訳:『これができるの?ChatGPT驚異のクローリング24題』)があります。
この本ではPythonベースのクローリングのサンプルコードがケース別によく整理されているので、初心者が流れをつかむのに適しています。
RSSニュースの収集、ECサイトの価格追跡、画像データの取得など、最初の一歩に適した状況別の課題を扱っています。
具体的なクローリング事例の分析としては、韓国気象庁の天気データを収集して気温の変化を可視化したり、YouTubeのコメントを取得して感情分析に活用したりする内容もよく登場します。
こうした実際の事例を繰り返し真似してみると、問題解決力が早く身につきます。
非エンジニアなら、無料のクローリングツールとして Screaming Frog や Octoparse といったGUIベースのツールから始めるのも一つの方法です。
クリックだけでURL構造の分析や内部リンクの収集ができるので、コードを書く負担がぐっと減ります。
実務での活用につなげるWebクローリング学習の5ステップ
- Webの構造を理解し、HTMLパースの概念を学ぶ
- BeautifulSoupとrequestsで簡単なサンプルを実習する
- GUIツール(Screaming Frogなど)でサイト構造を可視化する
- Seleniumなどで動的ページへの対応を練習する
- 実際のプロジェクトにデータを適用し、自動化を構築する
各ステップで必要な資料を並行して活用し、一気にクローリングの感覚をつかむことがポイントです。
筆者より
初めてWebデータを収集しようとしたとき、私も途方に暮れました。サイトの構造は複雑で、見よう見まねで書いたコードはエラーばかり。しかし、クローリングとWebスクレイピングがどう違い、それぞれどんな目的と方法で動くのかを正確に理解してからは、道が見えはじめました。
Webクローリングが全体構造を探索する「目」だとすれば、スクレイピングはその中から必要な情報を抜き出す「手」だと考えるとわかりやすいでしょう。この記事では、2つの技術の概念から、Pythonを使った実践例、動的コンテンツの処理、ツール選びのコツ、そして何より重要な法的な注意点まで、実践に必要な内容をひととおり取り上げました。
最後にひとつアドバイスをするなら、どのWebサイトからデータを収集するときも、まず「robots.txt」ファイルを確認してください。クロール可能な範囲とアクセスルールを事前に把握しておくだけで、多くの問題を防げます。長い記事を最後まで読んでいただき、ありがとうございました。データ収集を、もう一歩気軽に始めてみてください。